
Overview
22주 커리큘럼 기반으로 RecSys 전공 트랙을 이수하며 대회 2개를 거쳐 완성한 최종 팀 프로젝트. 뉴스를 '계산 가능한 데이터'로 정형화하고, LLM이 결론을 내리는 것이 아니라 판단 근거와 흐름을 단계적으로 제시하는 AI Agent 시스템을 설계했다.
22주 커리큘럼 기반 성장
AI Core 공통 9주 + RecSys 전공 12주. 대회 2개 → 최종 시스템 프로젝트 순서로 이론·실습·서빙 End-to-End 경험
LLM 오케스트레이터 설계
LLM을 답변 생성기가 아닌 판단·실행 통제 모듈로 제한. ReAct 패턴 + LangGraph 3노드 구조로 도구 호출과 응답 생성을 분리 설계
마이크로서비스 아키텍처
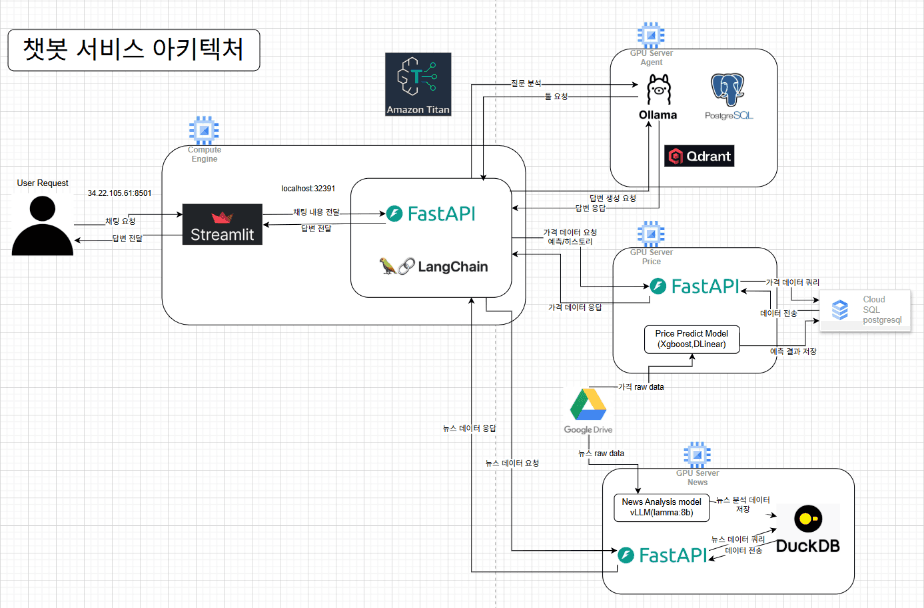
Agent / Price / Event 서버 분리 + FastAPI Cloud Orchestrator. GPU 서버 3대 + GCP 기반 외부 배포 환경 구축
이벤트 스키마 기반 데이터 정형화
비정형 뉴스 → 스키마로 구조화. LLM 출력을 검증 가능한 중간 단위로 제한
실시간 응답 최적화
SSE 스트리밍 + Python async 처리로 응답 30초 → 1초 이내. GIL 한계를 비동기 설계로 극복
RAG 기반 뉴스 큐레이션
Qdrant 네이티브 Range 필터 + Amazon Titan 임베딩. 한국어 질문 → 영어 번역 후 코사인 유사도 검색
Problem
- AI Core (공통, 9주): PyTorch 기초 / ML Lifecycle / EDA & 데이터 시각화 / Generative AI
- AI Production (RecSys 전공, 12주): 추천 시스템 모델링 심화 / Product Serving / 모델 최적화·경량화
| 단계 | 기간 | 내용 | 형태 |
|---|---|---|---|
| Core | 9주 | PyTorch / ML / EDA 등 | 이론 + 실습 |
| Production 1 | 초반 | 영화 추천 시스템 | 팀 대회 |
| Production 2 | 중반 | 도서 평점 예측 | 팀 대회 |
| Production 3 | 후반 | AYNIG AI Agent 시스템 | 팀 자유 프로젝트 |
- 뉴스 해석은 확률적·맥락 의존적 → Hallucination 발생 가능성 상시 존재
- 프롬프트를 수정해도 개선됐는지 측정할 기준 자체가 없는 상태
- "LLM 이벤트가 실제 가격 데이터와 정합적인가"를 검증할 구조 필요
- 원문 텍스트를 그대로 feature화 → 고카디널리티 / sparsity 문제
- 공급·수요 인과관계와 가격 변동의 방향·강도를 수치화하는 정형화 스키마 선행 필요
- 다중 서버 동기 호출 + 전체 응답 완료 후 반환 구조 → 응답 대기 30초 이상
- Python GIL 구조상 멀티스레드로는 해결 불가 → 비동기 설계 전환 필요
Solution
| 문제 | Before | After |
|---|---|---|
| LLM 검증 기준 | 없음 | GT 100건 + 1d/3d/5d Multiple Time Window 검증 |
| 뉴스 정형화 | 원문 텍스트 그대로 | event_type / mechanism / impact / confidence 8개 필드 스키마 |
| 응답 시간 | 30초 이상 (동기 처리) | 1초 이내 (SSE 스트리밍 + async) |
- Event schema 정의: event_type / mechanism / impact_direction(-1·0·1) / impact_strength(1·2·3) / confidence
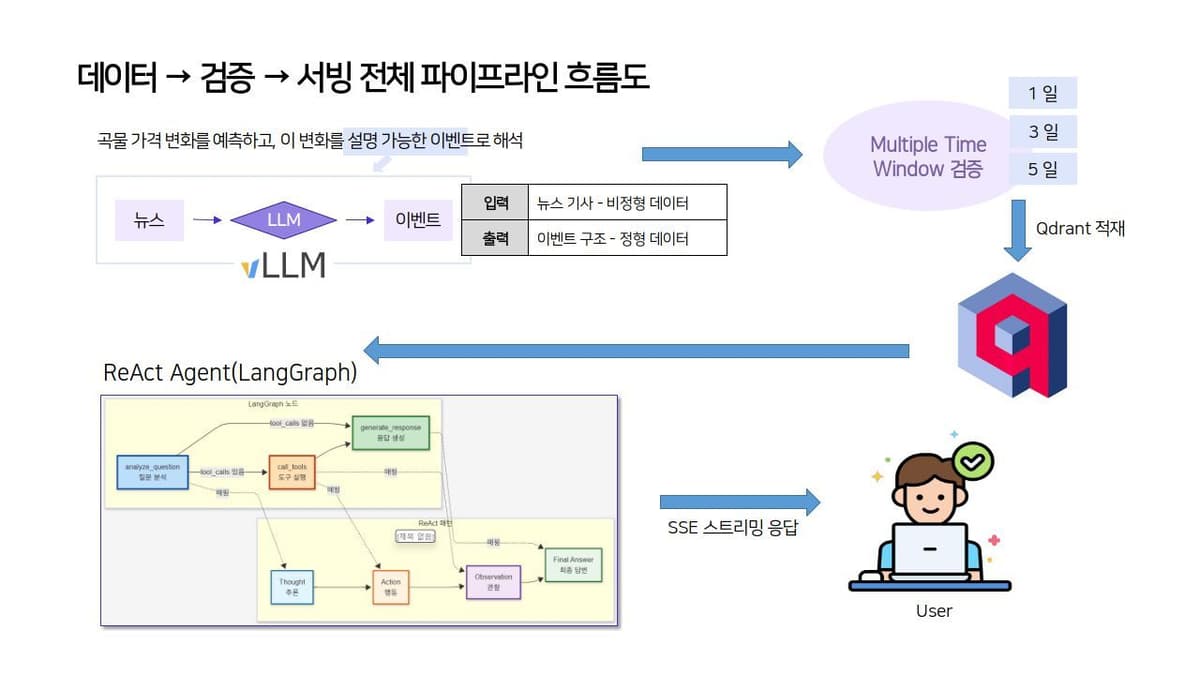
- LLM 출력 → 스키마 정형화 → GT 100건 구축 → 1d/3d/5d Multiple Time Window로 실제 가격 변화와 비교 검증
- 오답 패턴 3종 분류 (품목 인식 오류 / 과잉 라벨링 / 단어 매칭 오류) → reasoning 기반 Thinking Path 포함 V3 프롬프트 설계
- LLM(Llama3-8B)으로 뉴스 기사를 이벤트 스키마로 변환 → vLLM 분산 처리로 30만 건 대응
- 휴장일 뉴스 → 차기 개장일 매핑으로 시계열 정합성 확보
- 뉴스 빈도(Quantity) + 영향력 강도(Quality)를 결합한 Net-Impact 지표 설계
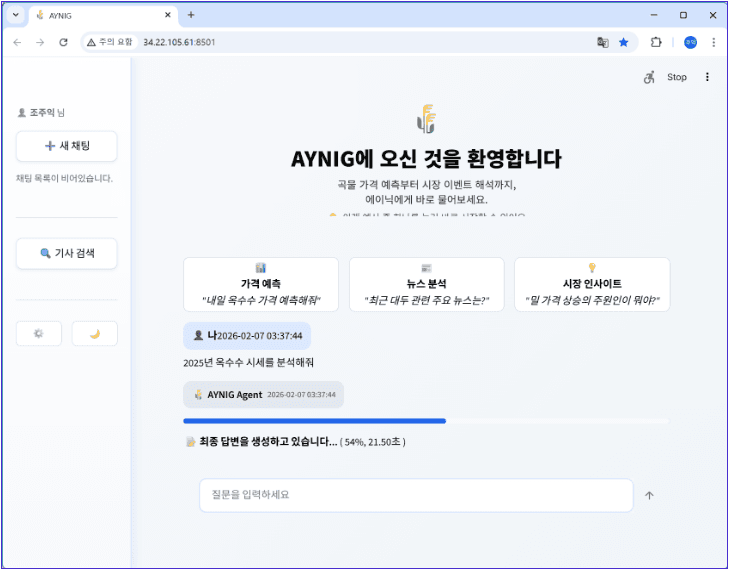
- FastAPI async + SSE 스트리밍 적용 → 질문 즉시 진행률 피드백, 1초 이내 첫 응답
- Agent / Price / Event 서버 분리 + Cloud Orchestrator FastAPI 중심 마이크로서비스 구조
Implementation
- 뉴스 데이터를 투자 의사결정 구조로 재정의 → LLM 역할을 자유 해석기가 아닌 스키마 출력 모듈로 제한
- GT 100건 직접 구축 (confidence Low:Mid:High = 3:4:3 비율 선정, 근거 메모 포함)
- Multiple Time Window 검증 설계: 1d(단기·노이즈 多) / 3d(안정적 시장 반응) / 5d(지속 방향 신호)
- 오답 패턴 3종 분석 → V3 프롬프트 솔루션 설계:
- Pattern 01: 다중 품목 누락 → Multi 규칙 명문화
- Pattern 02: 비사건성 뉴스 과잉 라벨링 → Impact 0 Few-shot 예시 추가
- Pattern 03: Macro 단순화 → 경제 추론 Thinking Path 강제
- Agent용 Event 분석 Tool 인터페이스 구현 / GitHub Project·Issue·브랜치 전략으로 팀 협업 프로세스 주도
- ReAct 패턴: 사용자 질문 분석 → 필요 도구 선택 → 병렬/순차 실행 → 최종 응답 생성
- LangGraph 3노드 구조: 분석(Classifier) → 도구 호출 → 응답 생성(CoT 전략)
- 5가지 Tool: 가격 예측 / 과거 가격 조회 / 이벤트 분석 / 통계 집계 / RAG 검색
- 3단계 프롬프트 체인: System Prompt(페르소나 정의) → Analysis Prompt(질문 분류기) → Response Prompt(CoT 기반 답변)
- XGBoost: 단기 예측. RSI / MACD / Bollinger Bands 등 기술 지표 + 뉴스 이벤트 feature 결합
- DLinear: 중장기 추세 예측
- Airflow 자동화 파이프라인 구축 → TradingView 데이터 수집 + Google Drive 자동 연동
- Qdrant Vector DB: 네이티브 Range 필터 + 복잡한 시계열 조건 조합으로 밀리초 단위 검색
- Amazon Titan Text Embeddings: 한국어 질문 → 영어 번역 후 임베딩 → 코사인 유사도 검색
- GCP Compute Engine 기반 외부 배포 / GPU 서버 3대 운영
Problem Solving
- 문제: GT 기반 V3 프롬프트 적용 후에도 성능 향상이 수치로 드러나지 않음
- 원인: 비전문가가 구축한 소규모(100건) GT는 모델 내재 편향 제거에 구조적 한계 존재 → 개선 효과 과소평가 가능
- 해결: "프롬프트가 무의미하다"가 아니라 "GT 품질과 모델 체급이 함께 개선돼야 효과가 드러나는 단계"로 결론 재정의 → 한계를 설계 요인으로 명확히 문서화
- 결과: 오답 패턴 3종 분류 자체는 유효 → 이후 더 큰 GT와 상위 모델 적용 시 개선 방향 확보
- 인사이트: LLM 검증은 GT 품질이 전제돼야 한다. 수치 없는 개선은 설계 방향만 남긴다
- 문제: DeepSeek-R1-distill 적용 시 내부 추론 과정이 길어져 정해진 스키마로 결과 추출 불가
- 원인: 모델이 구조화된 JSON 출력 전에 장문의 내부 추론을 먼저 생성 → 파싱 에러 빈발
- 해결: 운영 효율(반복 실험 속도)과 출력 파싱 안정성을 기준으로 Llama3-8B 선택
- 결과: Qwen2.5-32B(운영 비용), DeepSeek-R1(파싱 불안정) 제외 → 모델 선정 근거 데이터로 확보
- 인사이트: 모델 성능 수치보다 실제 운영 조건에서의 안정성이 선정 기준의 우선순위다
- 문제: AI Agent 응답 시간 30초 이상 → 실사용 불가
- 원인: Python GIL로 인해 멀티스레드 병렬 처리 불가 + 다중 서버 호출 동기 처리 + 전체 완료 후 일괄 반환
- 해결: FastAPI async + SSE 스트리밍 적용 → 질문 즉시 진행률 표시, 부분 응답 순차 전달
- 결과: 첫 피드백 1초 이내 달성. Polars Lazy 처리 도입으로 DataFrame 로드 속도·메모리도 개선
- 인사이트: 응답 속도 서빙 구조 좌우할 수 있다
Insight
- LLM에게 자유롭게 결론 내리도록 두면 시스템 전체가 설명 불가능해진다
- 역할을 스키마 출력 모듈로 제한하고, 출력을 검증 가능한 중간 단위로 만드는 것이 먼저
- "AI를 정답을 요구하는 대상이 아니라, 목적을 달성하기 위해 설계하고 통제해야 하는 도구로 인식"하게 된 프로젝트
- 대회 과정에서 쌓은 feature engineering / 분포 분석 / 재현 가능한 실험 설계 역량이 AYNIG 파이프라인 설계 기반이 됐다
- 22주 커리큘럼이 준 것은 기술 스택이 아니라 "데이터를 구조로 보는 사고 방식"
- 응답 30초 지연은 모델 문제가 아니었다 → Python GIL + 동기 구조의 문제
- Llama3-8B 선택도 성능 수치가 아닌 반복 실험 속도·파싱 안정성 기준으로 결정
- AI 시스템에서 운영 가능성은 아키텍처 설계 단계부터 고려해야 한다
Result
Outcomes
응답 시간 30초 → 1초 이내 — SSE 스트리밍 + Python async 처리 적용. GIL 한계를 비동기 설계로 극복
백테스트 수익률 우위 — 100일 과거 데이터 기반 시뮬레이션. 밀·옥수수·대두 3종목 모두 단순 Buy & Hold 대비 모델 시그널 참고 시 수익률 우위 기록
뉴스 296,514건 정형화 — 2017~2025 비정형 뉴스를 이벤트 스키마(8개 필드) 기반 구조화 데이터로 자동 변환
LLM 검증 구조 설계 — GT 100건 + 1d/3d/5d Multiple Time Window 검증. 오답 패턴 3종 분류 → V3 프롬프트 개선 반복
5가지 Agent Tool 구현 — 가격 예측 / 과거 가격 조회 / 이벤트 분석 / 통계 집계 / RAG 검색. 병렬·순차 실행 지원
모델 선정 근거 확보 — Qwen2.5-32B(운영 효율 열위), DeepSeek-R1(파싱 에러)를 실험으로 제외 → Llama3-8B 채택
Before / After Metrics
AI Agent 응답 시간
30초 → 1초뉴스 데이터 구조화
0건 → 296514건AYNIG — LLM 결과를 통제 가능한 구조로 만든 곡물 투자 AI 시스템 · Portfolio · Sojin Lee